бенчмарки

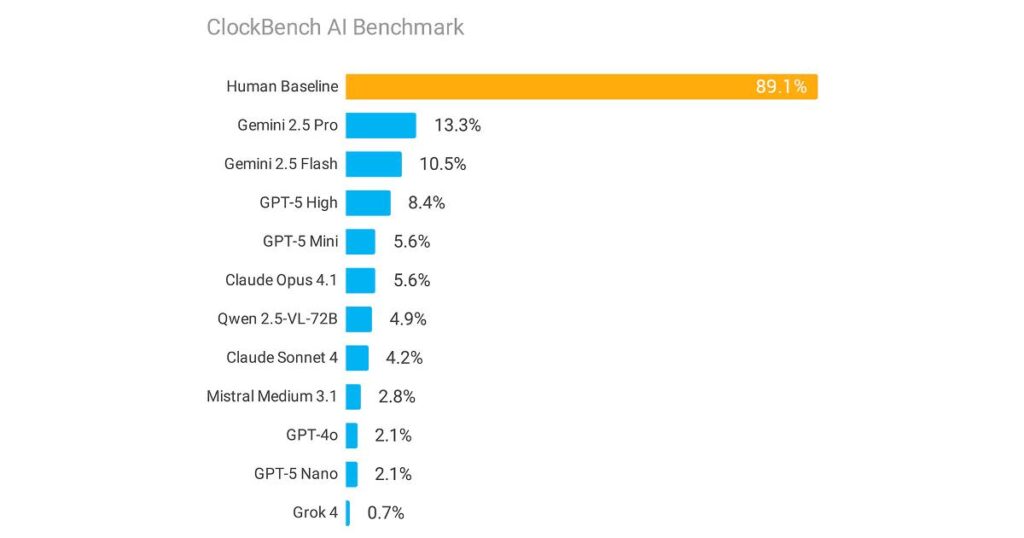
Сравнение результатов Claude Fable 5.1 на бенчмарке и примере с пеликаном на велосипеде, показывающее разницу между режимами мышления
Метрики

Пеликан на велосипеде против научного бенчмарка: что на самом деле показал релиз Claude Fable 5.1

Анонс новой модели почти всегда звучит одинаково: «новый стандарт», рекордный процент, таблица, где старая версия проигрывает новой. Именно так Anthropic представила Claude Fable 5.1, сделав акцент на научной работе и заявив о результате 52,6% на свежем Terminal-Bench-Science 0.1 — против 24,7% у предыдущей Fable 5, 29,0% у Opus 5 и 22,4% у GPT-5.6 Sol. Но самый показательный тест этого релиза оказался куда скромнее: обычный запрос «нарисуй SVG пеликана на велосипеде», прогнанный через все пять уровней «усилия мышления» модели. Разброс результатов там оказался таким, что заставляет иначе взглянуть и на громкий научный процент.
Схема локального ИИ в браузере с WebGPU-кернелами и измерением производительности на GPU
Блокчейн

207 WebGPU-кернелов Hugging Face: почему важнее не «2,57x быстрее», а то, как это измерили

Когда компания объявляет о выпуске сотен ускоренных операций для локального AI в браузере, первая реакция обычно одна: очередной раунд гонки за скоростью. Hugging Face выпустила библиотеку @huggingface/kernels и коллекцию из 207 WebGPU-кернелов, и заголовок с цифрой 2,57x уже готов разлететься по соцсетям как доказательство того, что AI в браузере наконец стал по-настоящему быстрым. Проблема в том, что эта цифра отвечает на гораздо более узкий вопрос, чем кажется, а самое интересное в релизе — не сама скорость, а то, как она теперь документируется и проверяется.

Kimi K3 и открытые веса: аналитический разбор лидерборда, бенчмарков и ограничений модели
Нейросети

Kimi K3: триллионы параметров, один громкий лидерборд и вопросы, которые остались без ответа

Когда компания выпускает модель на 2,8 триллиона параметров и сообщает, что она обошла флагман Anthropic в конкретном тесте, соблазн написать заголовок «новый чемпион» почти непреодолим. Moonshot AI выпустила Kimi K3 16 июля 2026 года, и заголовки не заставили себя ждать: модель обогнала Claude Fable 5 в бенчмарке фронтенд-кодинга Arena WebDev. Но если разобрать релиз по слоям — что доказано, что заявлено и что пока просто обещано — картина получается куда более сложной, чем «Китай обошёл Америку» или «open source наконец победил».

Схема платформенной стратегии OpenAI с GPT-5.6, где focus_keyword помогает понять выбор между уровнями моделей
Платформы

GPT-5.6 — это не «умнее», это «выбирай правильно»: разбор новой платформенной стратегии OpenAI

OpenAI анонсировала GPT-5.6, и первый рефлекс индустрии — сравнивать бенчмарки. Это понятно, но именно здесь и прячется главный сюрприз релиза: настоящая новость — не в цифрах на тестах, а в том, что компания перекроила саму архитектуру платформы. Один релиз — три модели с разными ролями, разными ценами и разными правилами доступа. Это уже не обновление, это переход к управляемой многоуровневой системе — и именно этот переход влияет на то, как команды и разработчики будут строить приложения в ближайшие месяцы.

Scroll to Top