искусственный интеллект

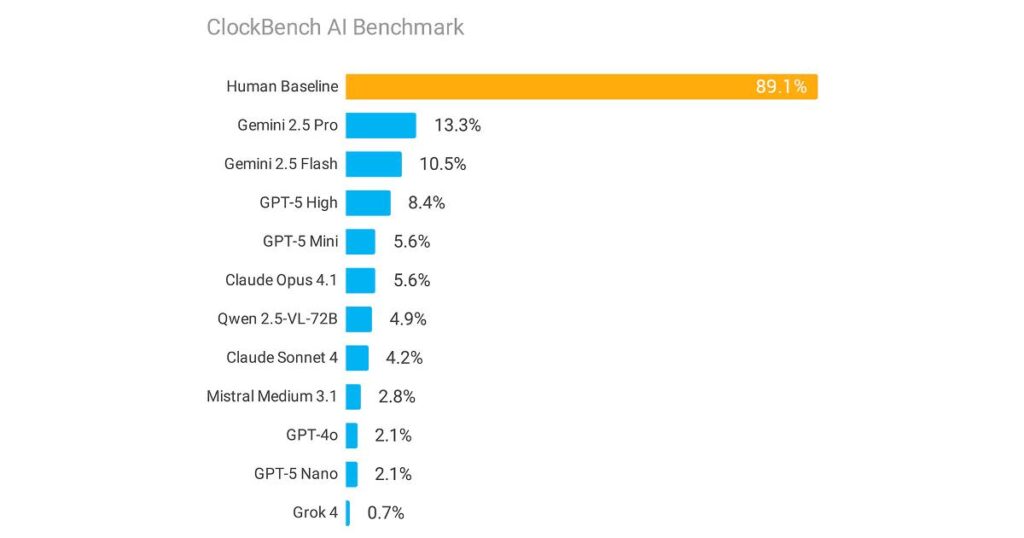
Сравнение результатов Claude Fable 5.1 на бенчмарке и примере с пеликаном на велосипеде, показывающее разницу между режимами мышления
Метрики

Пеликан на велосипеде против научного бенчмарка: что на самом деле показал релиз Claude Fable 5.1

Анонс новой модели почти всегда звучит одинаково: «новый стандарт», рекордный процент, таблица, где старая версия проигрывает новой. Именно так Anthropic представила Claude Fable 5.1, сделав акцент на научной работе и заявив о результате 52,6% на свежем Terminal-Bench-Science 0.1 — против 24,7% у предыдущей Fable 5, 29,0% у Opus 5 и 22,4% у GPT-5.6 Sol. Но самый показательный тест этого релиза оказался куда скромнее: обычный запрос «нарисуй SVG пеликана на велосипеде», прогнанный через все пять уровней «усилия мышления» модели. Разброс результатов там оказался таким, что заставляет иначе взглянуть и на громкий научный процент.
Демонстрация ИИ для кибербезопасности не доказывает надёжность в реальной среде и под атакой
Техномифы

ИИ в кибербезопасности: почему демо — это не доказательство

Когда Anthropic объявила о модели Claude Mythos Preview в апреле 2026 года, она сделала кое-что необычное для технологической компании: не стала продавать продукт широкой аудитории. Вместо этого запустила Project Glasswing — закрытую инициативу с участием Amazon Web Services, Apple, Cisco, Google, Microsoft и ряда других компаний — и прямо предупредила, что модель способна «превзойти всех, кроме наиболее квалифицированных специалистов, в поиске и эксплуатации уязвимостей». Такая формулировка из уст самого разработчика заслуживает внимания. Но она же обнажает фундаментальное противоречие: если ИИ действительно настолько силён, почему закрытый доступ считается достаточным ответом на вопрос о безопасности?

Scroll to Top